 aigeek編集部
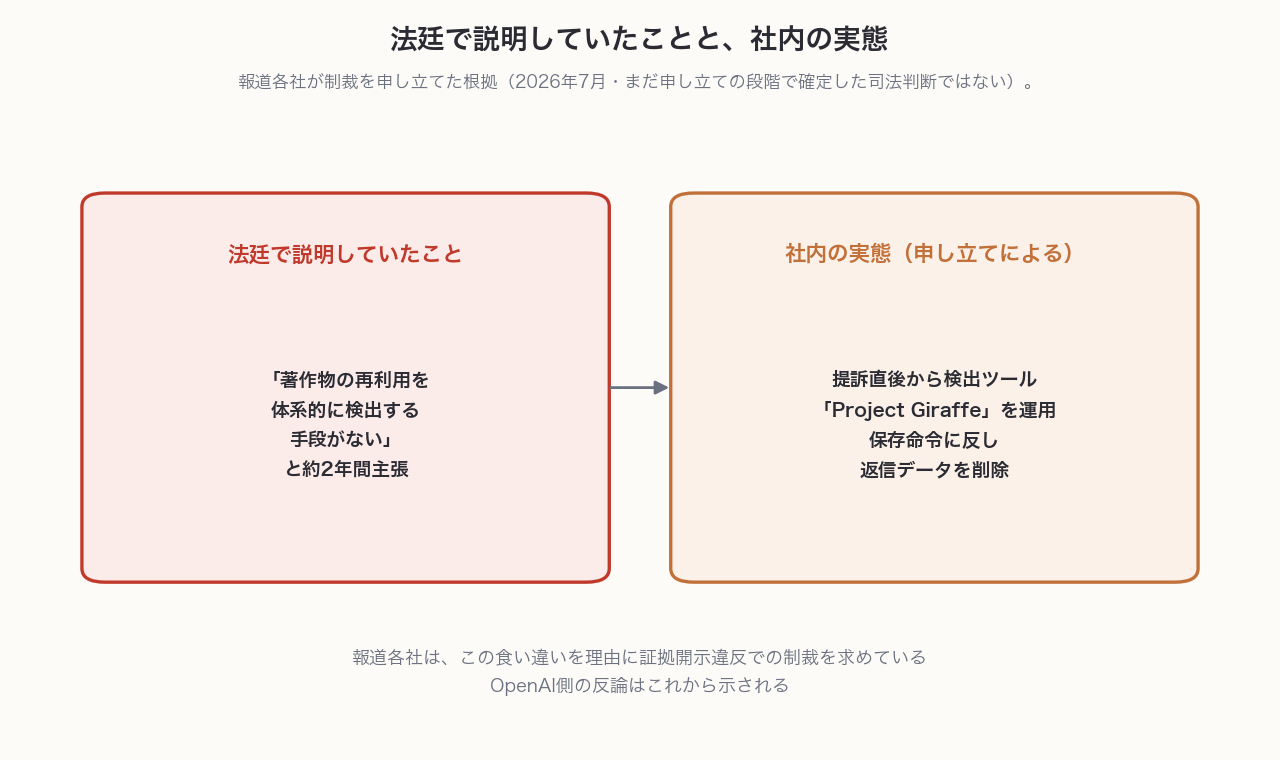
ChatGPTを提供するOpenAIは、ニューヨーク・タイムズなど報道各社との著作権訴訟で、「自社の記事がChatGPTの回答にどれだけ再利用されているかを体系的に調べる手段がない」と約2年にわたって説明してきた。ところが2026年7月、報道各社は連邦裁判所に、OpenAIに対する制裁を申し立てた。根拠は、提訴の直後から社内で「Project Giraffe」という検出ツールを運用していたことが証言で明らかになったこと、そして裁判所の保存命令に反して大量の返信データを削除していたと主張されていることだ。この訴訟ではもう一つ、OpenAI自身が「2,000万件で十分」と提案した数字が、そのままOpenAIを縛る命令になったといういきさつもある。まだ申し立ての段階で、裁判所の最終判断は出ていない。それでも、AIサービスを仕事で使う側にとって見過ごせない材料がここにはある。
自分で言った数字が、そのまま命令になった
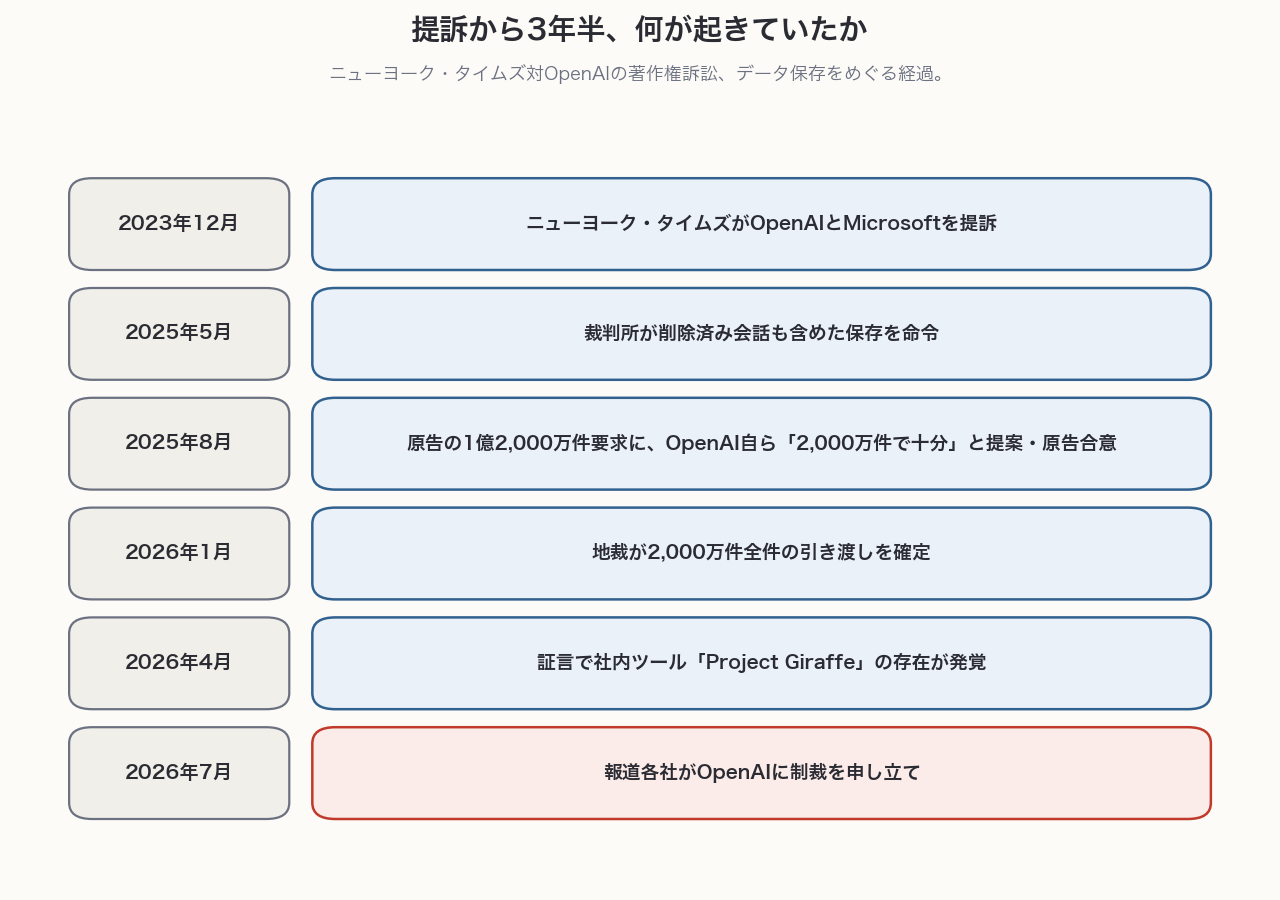
発端は2023年12月、ニューヨーク・タイムズがOpenAIとMicrosoftを、著作権侵害を理由に提訴したことだった。争点は、ChatGPTの学習や応答に新聞記事が無断で使われているかどうかだ。裁判では、判決の前に双方が持っている資料を出し合う「証拠開示」という手続きがある。この手続きの中で、原告側は当初、ChatGPTのやり取りのログを1億2,000万件求めた。これに対しOpenAIは「2,000万件で十分なはずだ」と自ら提案し、原告側もこれを受け入れた。
ところが2025年10月になって、OpenAIは方針を変える。全件を渡す代わりに、原告の著作物に関係する語句だけをキーワード検索して抽出したい、と申し出たのだ。この変更は同年11月に担当判事に却下され、OpenAIは不服を申し立てたが、2026年1月5日、連邦地裁のシドニー・スタイン判事が却下を支持する判断を下した。判事は「利用者のプライバシーと、証拠としての関連性は、既存のプライバシー保護の仕組みの中で適切にバランスが取られている」と述べたと報じられている。結果として、OpenAIは自ら提案した2,000万件全件を、匿名化完了から7日以内に引き渡すよう命じられることになった(この期限自体は2025年11月の担当判事の命令によるもので、スタイン判事の判断はそれを追認する形だった)。自分が「妥当だ」と示した数字が、そのまま自分を縛る命令に変わった格好だ。
消すなと言われていたのに、消えていた
この訴訟には、もう一つの伏線がある。2025年5月、裁判所は証拠保全のため、OpenAIに対し、ユーザーが削除した会話や履歴に残さない「一時的なチャット」も含め、本来なら消えるはずのデータを消さずに残すよう命じていた。OpenAIはこの命令を自社ブログで「プライバシーの行き過ぎ」と公に批判しつつも、これに従う形を取ってきた。この保存義務は2025年9月26日に終了し、以降は通常どおり削除から30日でデータが消える運用に戻っている。
ところが2026年7月9日、ニューヨーク・タイムズやニューヨーク・デイリー・ニューズ、シカゴ・トリビューンを含む複数の報道各社が、連邦裁判所に制裁を申し立てた。申し立てによれば、OpenAIは保存命令に反して数十億件規模のChatGPTの返信データを削除しており、原告側の弁護士や調査担当者は、残された8,000万件以上の返信データを一件ずつ突き合わせて復元する作業を強いられたという。裁判所から「消すな」と言われていたはずのデータが、消えていた、という主張だ。
「測れない」と言いながら、測る道具を先に作っていた
申し立てのもう一つの柱が、OpenAI側の説明そのものへの疑義だ。原告側の弁護士スティーブン・リーバーマン氏は「OpenAIは、著作物がどう再利用されているかを検索する自社の能力について、この2年間ずっと事実と異なる説明をしてきた」と主張している。転機になったのは2026年4月、裁判所命令によるOpenAI側専門家の証言だった。証言によれば、OpenAIは提訴からほどなくして、社内で「Project Giraffe」と呼ばれる取り組みを立ち上げていた。これは、ChatGPTの回答がニュース記事の文章をそのまま含んでいないかを自動でチェックする社内ツールで、原告側はこれを「OpenAIが法廷で『測れない』と言い続けていた、まさにその侵害を記録した社内記録」だと位置づけている。
報道各社は、この食い違いを理由に、OpenAIが証拠開示手続きで意図的に情報を隠し、証拠を破棄したとして、裁判所に次のような制裁を求めている。すでに引き渡された2,000万件のログをOpenAI側の証拠として使わせないこと、ChatGPTのログが著作物を相当量再利用していたという事実を裁判所があらかじめ認めた前提として扱うこと、原告側の弁護士費用をOpenAIに負担させること、の3点だ。これらはあくまで原告側の主張であり、ここまでは片側の言い分だという点は押さえておく必要がある。
OpenAIの反論——「歴史を書き換えようとしている」
OpenAIは2026年8月14日、この申し立てに対する反対意見書を裁判所に提出した。内容は、原告側の主張をほぼ全面的に否定するものだ。Project Giraffeについては「原告が求めているものとは目的も設計も根本的に異なる、大まかな(rough-and-ready)社内調査にすぎない」と説明し、対象は約7,800万件の会話という限定的なサンプルだったと述べている。データの削除についても「保存命令には文字どおり従った」「(復元のために)途方もない労力を費やした」と反論し、削除されたのは全体の約5%にとどまり、削除分は偏りが出ないよう他のログに置き換えたと主張している。そのうえでOpenAIは「訓練データや出力ログの全体を横断的に検索することは、技術的にできないというのが現実だ」との立場を崩さず、原告側には「ChatGPTが記事を組織的に再生成しているという証拠が何もない」、今回の申し立ては「自分たちの立証責任を回避する試み」であり「歴史を書き換えようとしている」とまで述べている。
自分ごととして——対象になるプラン、日本のユーザーも例外ではない
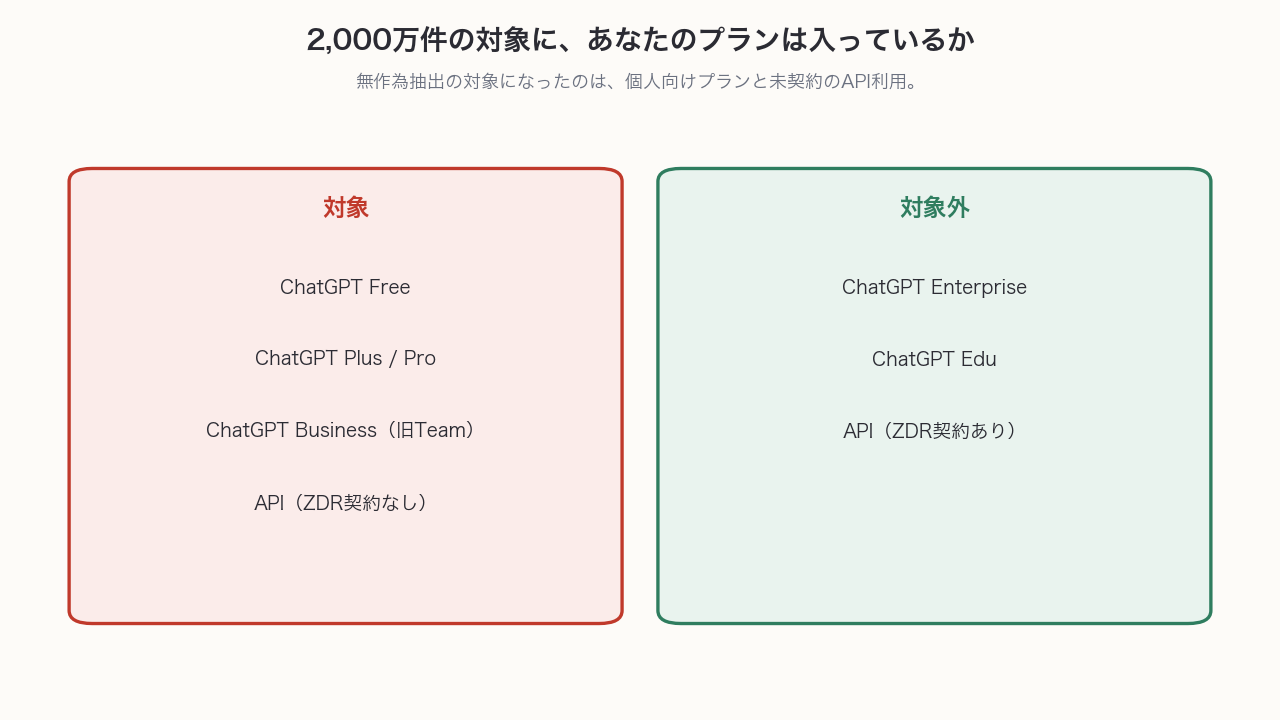
ここまでの話は、法廷の攻防だけの話ではない。無作為に抽出された2,000万件の中身は、実際にChatGPTへ打ち込まれた会話そのものだ。対象になったのは、ChatGPT の無料版・Plus・Pro、そして2025年8月に名称変更されたBusiness(旧Team)、および開発者向けAPIのうち、会話を一切保存しない特別契約(ゼロデータ保持契約)を結んでいない利用分だ。除外されているのは、企業向けのEnterprise・教育機関向けのEduと、そのゼロデータ保持契約を結んだAPI利用のみだ。
期間は2022年12月から2024年11月までの会話が母集団で、そこからランダムに2,000万件が選ばれている。渡る前には個人が特定できる情報が取り除かれ(匿名化)、裁判所の保護命令の下で原告側弁護士のみが閲覧できる。世の中に公開されるわけではない。もう一点、見落とされがちな条件がある。OpenAIの公式説明では、無期限保存の対象から外れたのは欧州経済領域・スイス・英国から送られた会話のみで、日本からの利用はこの除外に含まれていない。つまり日本から個人向けプランで使っていた会話も、対象になりうる母集団に入っていたことになる。
「AIが決めたこと」の責任を誰が負うのか、という同じ根の問題
AIサービスを提供する企業が、法廷や利用者に対して説明していることと、社内での実態にズレがあるかもしれない——という構図は、今回が初めてではない。裁判資料にAIへの指示を紛れ込ませた原告本人が制裁を科された事例や、AIチャットボットが勝手に約束した割引を、会社が支払うべきだと判断された事例は、どちらも「AIが決めたこと・書いたこと」の責任を誰が負うのかという同じ根の問題だ。今回はそれが一歩進み、「AIベンダーが法廷に説明した内容そのものが正確だったか」が争点になっている。2026年7月はAI業界で事故や訴訟が相次いだ月でもあったが、この件はその中でも、AIベンダーの説明責任という一段深いところに触れている。
わかっていないこと
2026年7月の制裁申し立ても、8月のOpenAIの反対意見書も、どちらも当事者どうしの言い分であり、裁判所がどちらの言い分を認めるかはまだ決まっていない。「Project Giraffe」の技術的な仕組みの詳細や、削除されたと主張される返信データが具体的に何件だったか(数十億件という原告側の主張と、5%程度というOpenAI側の主張のどちらが実態に近いか)の確定値は、報道の範囲では明らかになっていない。また、2,000万件のログが実際にいつ原告側へ引き渡されたか、その後どこまで分析が進んでいるか、そしてこの反対意見書に対して原告側が再反論しているかについても、確認できる続報は見つからなかった。
【編集メモ】
本記事は2026年8月27日時点で確認できた情報にもとづく。主な出典はBloomberg Law、National Law Review、Jones Walker LLP、TechCrunch、Euronews、The Spokesman-Review等の報道および法律専門メディア、OpenAI公式ブログ(Brad Lightcap名義)。制裁申し立ての中身は原告側の主張、8月の反対意見書はOpenAI側の主張であり、いずれも司法として確定した事実ではない点を本文中に明記した。図解3枚は編集部(Claude)がmatplotlibで作成した。
参考・出典
- Bloomberg Law「OpenAI Must Turn Over 20 Million ChatGPT Logs, Judge Affirms」
- Jones Walker LLP「OpenAI Loses Privacy Gambit: 20 Million ChatGPT Logs Likely Headed to Copyright Plaintiffs」
- TechCrunch「New York Times says OpenAI hid evidence in ChatGPT copyright trial」
- The Spokesman-Review「Newspaper groups seek ‘serious sanctions’ against OpenAI as deception alleged in copyright lawsuit」
- Euronews「News outlets seek sanctions against OpenAI in copyright battle」
- OpenAI公式「Response to NYT data demands」(Brad Lightcap名義)
- Bloomberg Law「OpenAI Says NY Times Seeks Sanctions Due to Lack of Evidence」(2026年8月・反対意見書の報道)

 HALBo