 aigeek編集部

ローカル LLM をきっかけに、AI の正体を一つずつ掘り下げる対話が続いている。前回は、AI が長い文章を「次の一語の予測」をひたすら繰り返して書いていることに辿り着いた。足し算で文章を建てていく書き手だ、という話だった。すると原さんから、当然の問いが来た。
原さん:じゃあ、画像や動画も同じ仕組みなんですか?
面白い問いだ。そして答えは——「いいえ、多くは違う仕組み」。ここが意外と知られていないポイントだ。
テキストと画像は、生成の方向が逆
前回話した通り、テキスト(LLM)は自己回帰だった。左から右へ、一語ずつ積み上げていく。白紙に文章を書き足していく作家のイメージだ。
ところが、いま画像生成の主流になっている仕組みは、これとまったく逆の発想をする。「拡散モデル(diffusion model)」と呼ばれるもので、Stable Diffusion・Midjourney・DALL-E などがこれにあたる。
拡散モデルは、砂嵐(ノイズ)から始めて、それを少しずつ削り出して画像にする。いわば引き算で画像を彫り出していく。
どういうことか:砂嵐から像が浮かび上がる
仕組みを順に追うと、こうなる。
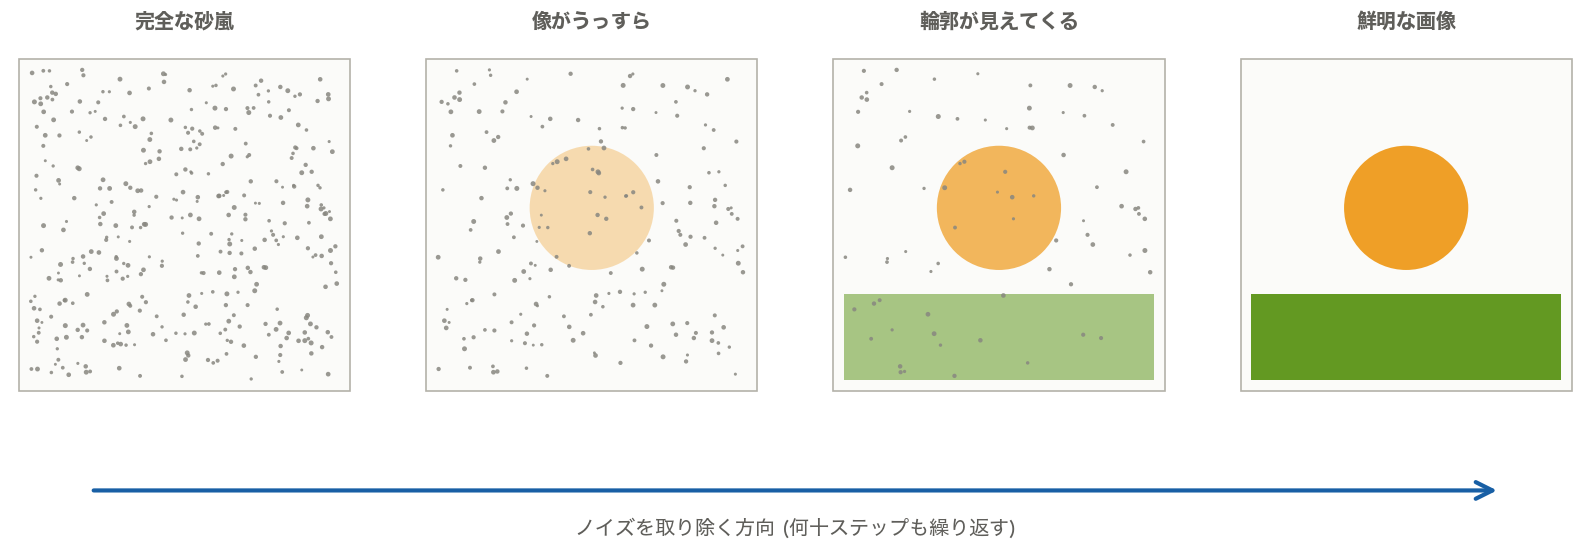
訓練のとき。本物の画像に、少しずつノイズを足していく。最終的に、元が何だったか分からない完全な砂嵐になるまで。そして AI に「この砂嵐から、さっき足したノイズを逆算して取り除け」と教え込む。
生成のとき。今度は完全な砂嵐からスタートする。そこから「このノイズを取り除けばそれらしくなる」を何十回も繰り返して、徐々に像をくっきりさせていく。
たとえるなら、彫刻家
テキスト生成が「白紙に一語ずつ書き足していく作家」だとすると、画像生成は「大理石の塊から像を彫り出す彫刻家」だ。
ミケランジェロは「石の中にすでに像があり、私は余分を取り除くだけだ」と言ったとされる。拡散モデルはまさにそれをやっている。砂嵐という塊の中から、余分なノイズを削り、像を浮かび上がらせる。
古いテレビの砂嵐が、だんだんピントが合って映像になっていく——あの感覚が一番近いかもしれない。
動画も基本は同じ(拡散)
Sora や Veo のような動画生成も、ほとんどが拡散モデルの仲間だ。違いは、時間方向も一緒に扱うこと。画像が「縦×横」のノイズを削るなら、動画は「縦×横×時間」のノイズの塊を、一気に削り出していく。だから動画生成は画像より桁違いに重い計算になる。
でも、根っこは同じ
仕組みは違っても、最も深い部分は前回までの話とまったく同じだ。
どちらも、「9GB に何が入っているのか」で話した通り、訓練データそのものは持っていない。本物の画像を保存しているのではなく、「猫らしさ」「夕焼けらしさ」といったパターンを抽出して焼き付けているだけだ。だから存在しない猫の画像を、無限に生成できる。
テキストは足し算、画像は引き算。生成の向きは逆でも、圧縮されたパターンから「それらしいもの」を作り出す、という核心は共通している。どちらも初期にランダム性を持つので、同じ指示でも毎回少し違う結果になるのも同じだ。
ただし、境界は溶けつつある
面白いのは、最近この区別が少しずつ曖昧になっていることだ。
たとえば 2025 年に登場した GPT-4o のネイティブ画像生成は、拡散ではなく、テキストと同じ自己回帰方式——画像を「トークン」の列として一個ずつ予測する——に戻っている。逆に、テキスト生成に拡散方式を持ち込む研究も進んでいる。
つまり「テキストは足し算、画像は引き算」という今の整理も、数年後には古くなっているかもしれない。技術の現場は、まだ揺れ動いている最中だ。
それでも、変わらない一点がある。AI は、見たものを覚えているのではない。膨大なものから抽出した「らしさ」を頼りに、毎回ゼロから——白紙からであれ、砂嵐からであれ——何かを立ち上げている。書くのも、描くのも、その点では同じことなのだ。

 HALBo